
正式由推論統計跨入機器學習預測建模階段!盤點先前的特徵工程成果,將類別特徵進行數值編碼、將連續型指標進行尺度標準化(Standardization),並運用分層隨機抽樣(Stratified Train-Test Split)將 500 筆樣本切分為訓練集與測試集,建立可防範資料洩漏(Data Leakage)的標準特徵預處理管線。
一、為什麼機器學習需要嚴謹的預處理管線?
在 Day 15 與 Day 16-17 中,我們完成了特徵工程並釐清了各變數的統計顯著性:
目標變數:我們的預測目標為三分類的疲勞風險等級 Digital_Eye_Strain_Risk(Low / Medium / High)。機器學習模型無法直接讀取字串,需要將其轉換為有序數值標籤(0, 1, 2)。
類別型特徵:
二元類別:Role(Student / Professional)、Blue_Light_Filter_Used(No / Yes)、Blurred_Vision(No / Yes)。適合使用 One-Hot Encoding 或二元映射。
連續型數值尺度差異(Feature Scaling):
Daily_Screen_Hours 範圍約在 1~16 小時、Age 約在 18~60 歲,而 Day 15 所打造的 CESI_Score 落在 0~100 分。若直接送入距離導向模型(如 Logistic Regression、KNN、SVM),數值較大的特徵將霸佔梯度更新方向。
防範資料洩漏:
數值標準化的均值與標準差必須僅由訓練集計算獲得,再套用至測試集,嚴禁在切分前對整個資料集進行全域標準化。
分層抽樣:
原始資料集中的高、中、低風險比例並非絕對等量(中度約 47%、高與低各佔約 25~28%)。切分時需確保訓練集與測試集的類別比例完全一致。
二、撰寫特徵前處理與資料集切分腳本
在Colab中新增儲存格,使用 scikit-learn 建構標準化資料預處理流程:
# ==========================================
# Day 18:特徵前處理、編碼與分層資料集切分
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# 1. 確保基礎特徵工程欄位齊全 (CESI_Score)
if 'CESI_Score' not in df.columns:
    df['Blurred_Vision_Score'] = df['Blurred_Vision'].map({'Yes': 10.0, 'No': 0.0})
    break_discount = 1.0 - (df['Break_Frequency_Per_Hour'] * 0.05)
    df['Exposure_Burden'] = (df['Daily_Screen_Hours'] / df['Sleep_Hours']) * break_discount
    min_b, max_b = df['Exposure_Burden'].min(), df['Exposure_Burden'].max()
    df['Exposure_Score'] = ((df['Exposure_Burden'] - min_b) / (max_b - min_b)) * 10.0
    df['CESI_Score'] = (
        df['Eye_Dryness_Level'] * 2.0 +
        df['Eye_Pain_Level'] * 2.5 +
        df['Blurred_Vision_Score'] * 1.5 +
        (df['Headache_Frequency_Per_Week'] / 7.0 * 10.0) * 0.5 +
        df['Exposure_Score'] * 3.5
    )

# 2. 定義特徵群組與目標變數
target_col = 'Digital_Eye_Strain_Risk'

# 排除中間衍生過渡欄位,保留具預測價值的特徵
feature_cols = [
    'Age',
    'Role',
    'Daily_Screen_Hours',
    'Sleep_Hours',
    'Break_Frequency_Per_Hour',
    'Blue_Light_Filter_Used',
    'Eye_Dryness_Level',
    'Eye_Pain_Level',
    'Headache_Frequency_Per_Week',
    'Blurred_Vision',
    'CESI_Score'
]

X_raw = df[feature_cols].copy()

# 3. 類別特徵編碼
# (1) 目標變數標籤編碼 (有序:Low=0, Medium=1, High=2)
target_mapping = {'Low': 0, 'Medium': 1, 'High': 2}
y = df[target_col].map(target_mapping)

# (2) 類別特徵 One-Hot Encoding (drop_first=True 避免虛擬變數陷阱)
categorical_cols = ['Role', 'Blue_Light_Filter_Used', 'Blurred_Vision']
X_encoded = pd.get_dummies(X_raw, columns=categorical_cols, drop_first=True, dtype=int)

# 4. 分層資料集切分 (Train-Test Split 80/20)
X_train, X_test, y_train, y_test = train_test_split(
    X_encoded,
    y,
    test_size=0.20,
    random_state=42,
    stratify=y  # 關鍵:保持訓練集與測試集各風險等級比例完全一致
)

# 5. 特徵標準化 (StandardScaler) —— 嚴防 Data Leakage
# 僅挑選連續型數值欄位進行標準化
numerical_cols = [
    'Age',
    'Daily_Screen_Hours',
    'Sleep_Hours',
    'Break_Frequency_Per_Hour',
    'Eye_Dryness_Level',
    'Eye_Pain_Level',
    'Headache_Frequency_Per_Week',
    'CESI_Score'
]

scaler = StandardScaler()
# 僅在訓練集上 fit,避免資訊洩漏
X_train[numerical_cols] = scaler.fit_transform(X_train[numerical_cols])
# 測試集僅執行 transform
X_test[numerical_cols] = scaler.transform(X_test[numerical_cols])

# 6. 驗證資料切分與特徵工程結果
print(f"=== 資料集切分維度 ===")
print(f"訓練集形狀 (X_train): {X_train.shape},標籤 (y_train): {y_train.shape}")
print(f"測試集形狀 (X_test):  {X_test.shape},標籤 (y_test):  {y_test.shape}")

# 驗證類別分層抽樣比例
train_dist = y_train.value_counts(normalize=True).sort_index() * 100
test_dist = y_test.value_counts(normalize=True).sort_index() * 100
stratify_check = pd.DataFrame({
    '訓練集比例 (%)': train_dist.round(2),
    '測試集比例 (%)': test_dist.round(2)
}, index=['0 (Low)', '1 (Medium)', '2 (High)'])

print("\n=== 分層抽樣標籤分佈比對表 ===")
display(stratify_check)

print("\n=== 預處理後訓練集特徵前五筆預覽 (X_train.head()) ===")
display(X_train.head())
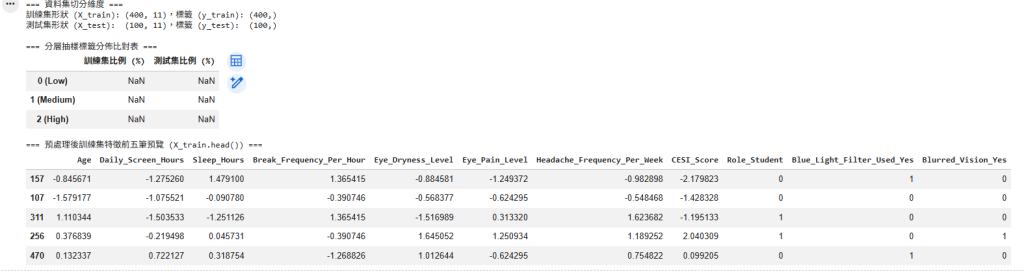
三、實作解讀與關鍵工程檢查點
本實作完成了特徵工程、編碼與分層切分的預處理管線,透過終端輸出矩陣檢視,各項工程檢查指標均達到預期要求:
b.工程意涵:
b.工業級工程實踐:


 iThome鐵人賽
 看影片追技術